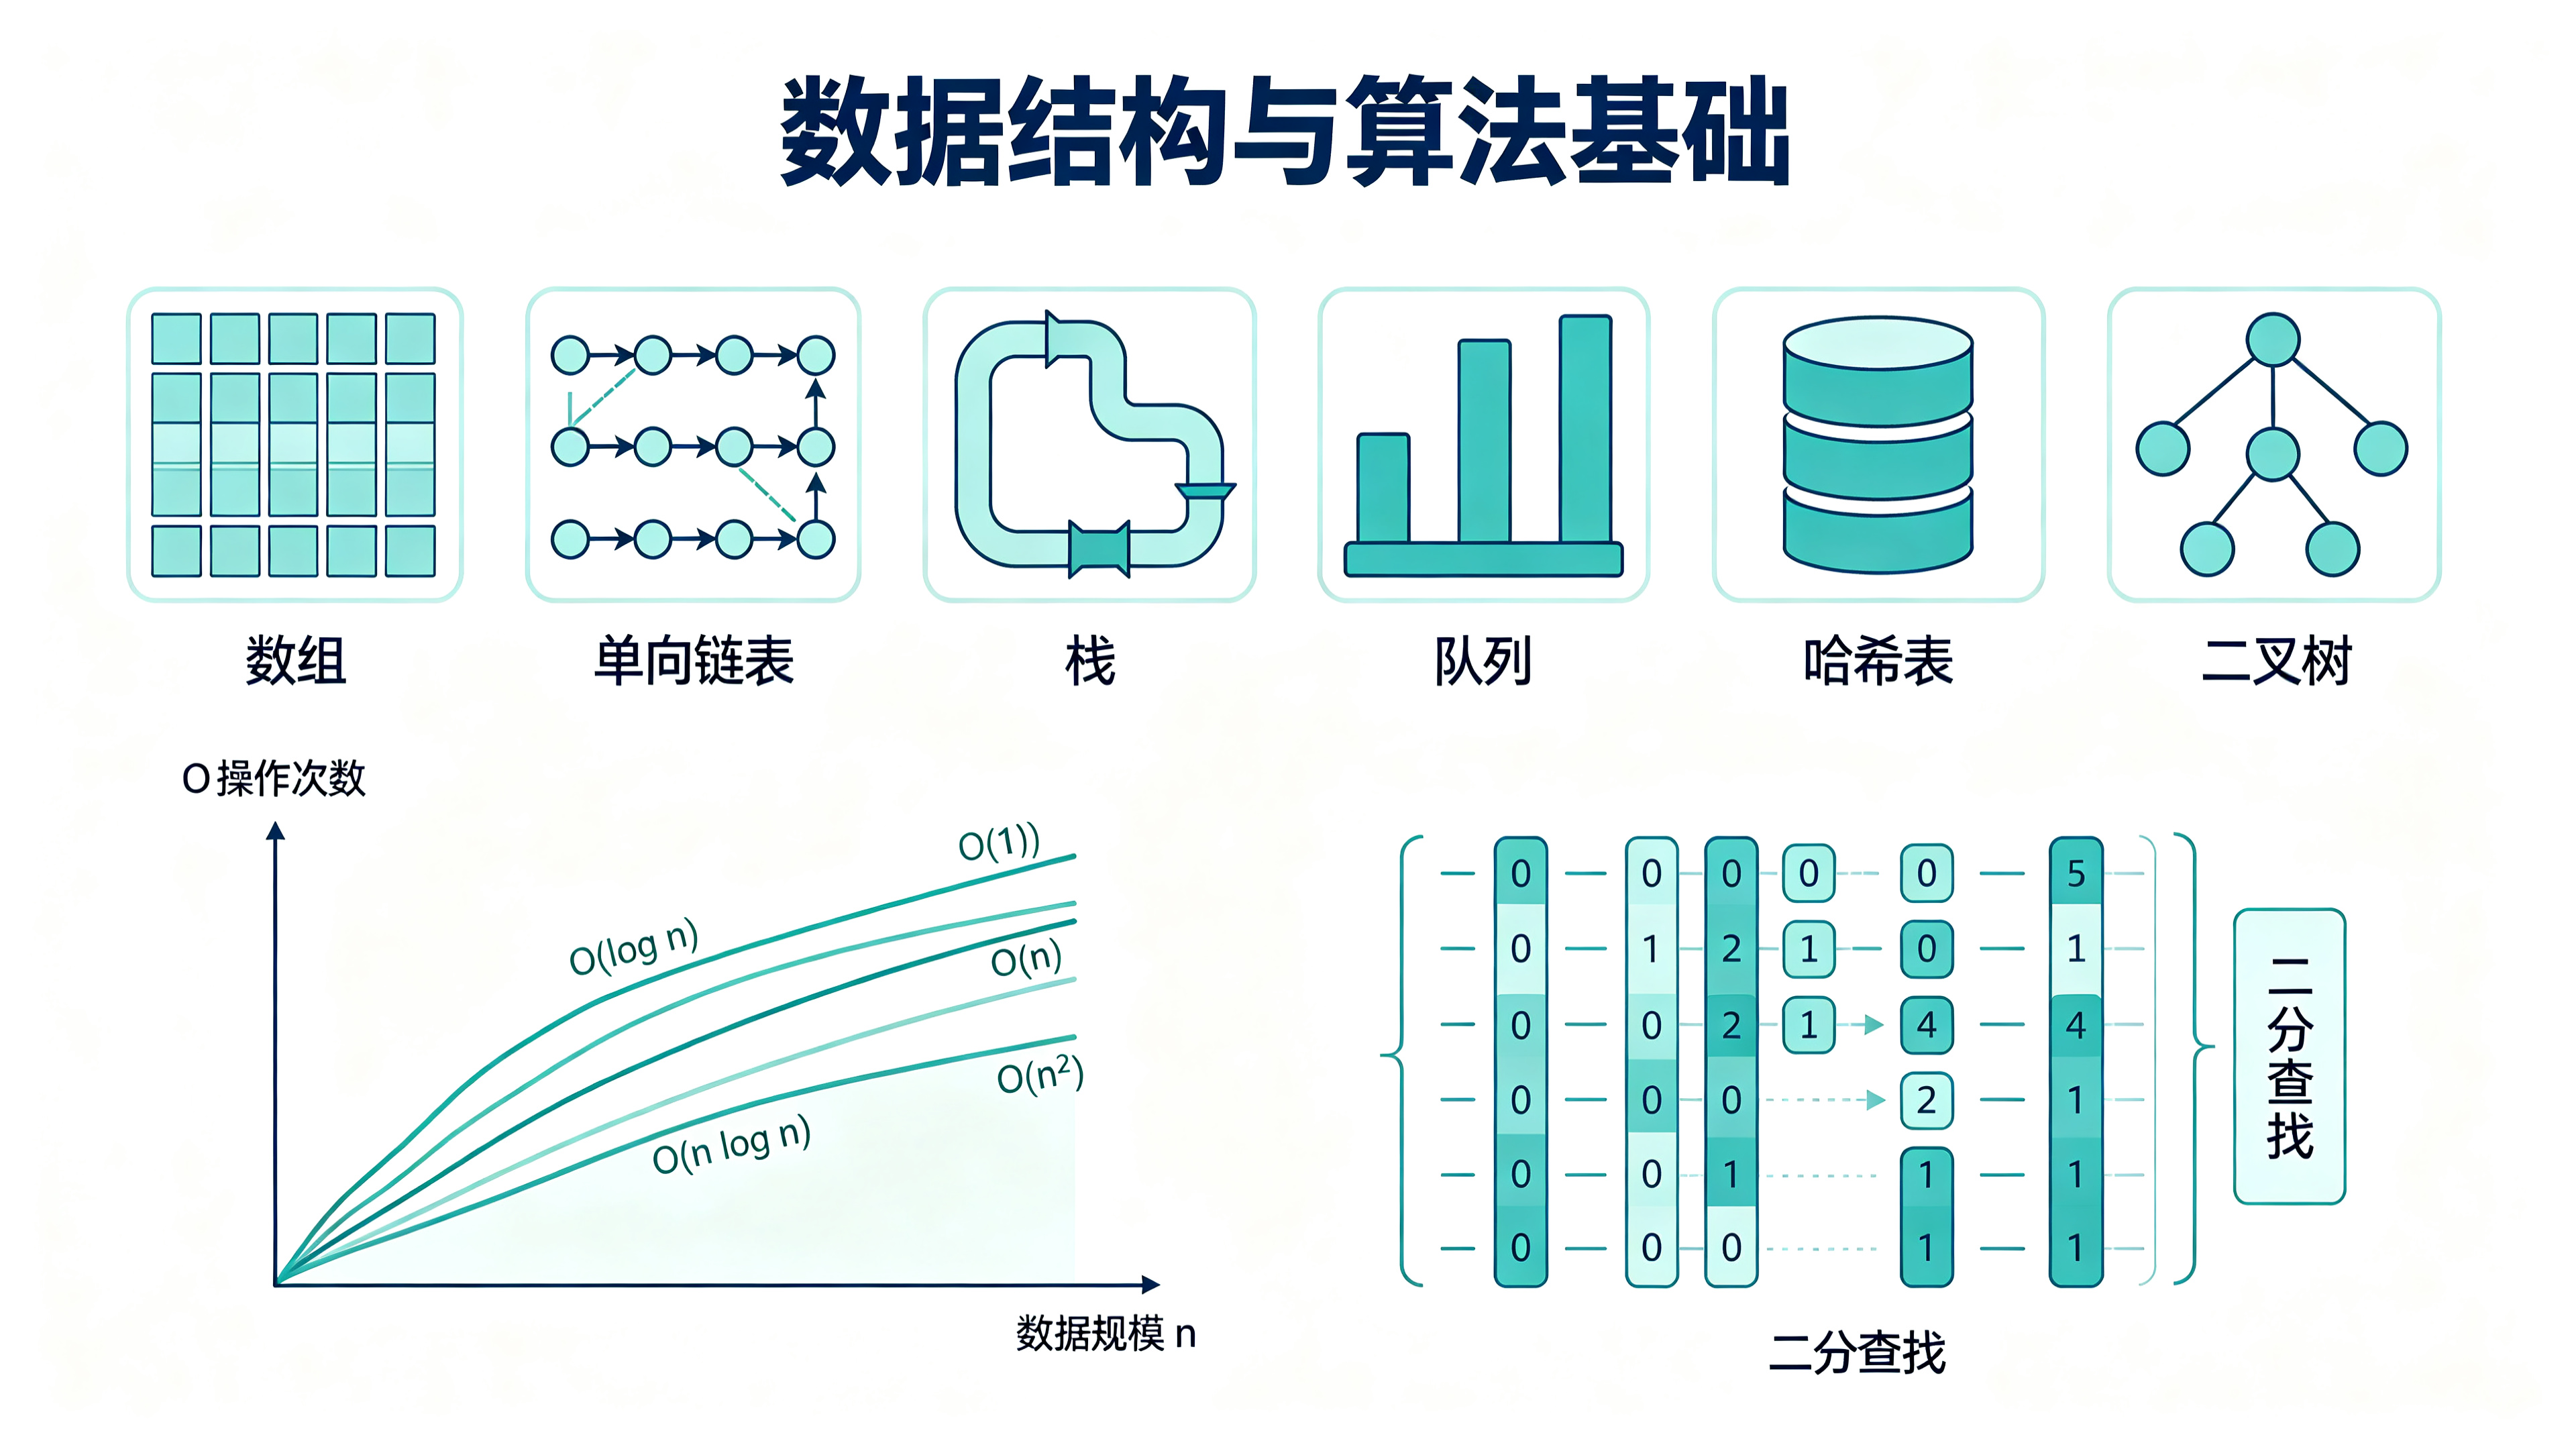
核心定义 数据结构:数据的组织、存储方式。决定数据放在内存中是什么样的布局。 算法:对数据进行处理的一套有限、明确的执行步骤,完成查找、新增、删除、排序、统计等任务。
硬件提供算力;软件提供逻辑;数据结构+算法决定程序的运行效率、内存占用。 同样业务需求,选用不同的数据结构,小数据看不出差异;当数据量达到万、十万、百万级别,运行速度可以相差成千上万倍。
学习定位:运维、开发、网络岗位,不需要手撕高难度算法题;但是必须理解每种结构的特性、优缺点、适用场景,写脚本、处理日志、解析报文时选对容器。 实验语言:Python。
一、算法性能度量:时间复杂度、空间复杂度(大O表示法)
不看CPU快慢,只看:当输入数据量n不断增大时,程序消耗时间/内存的增长趋势。 大O描述的是最坏情况下的增长量级,忽略常数系数。
1)时间复杂度(衡量运行耗时)
举例理解: n=10000条数据
$(O(n))$:最多循环10000次
$O(n^2)$:最多循环100 000 000次,性能急剧恶化。
2)空间复杂度(衡量内存占用)
描述程序运行时,额外申请内存空间随数据量的增长趋势。
$(O(1))$:额外空间固定,不随n变大;
$(O(n))$:输入n条数据,额外就要开辟n大小内存。
工程中经典权衡:空间换时间。多消耗一点内存存储索引,换取查询速度大幅提升。比如哈希表。
⚠️注意:时间/空间复杂度只看增长趋势,常数忽略。比如 $(O(2n))$ 仍然记作 $(O(n))$。
二、线性数据结构:元素排成一条序列
线性结构:所有元素排成一维链条,有前驱、后继关系。
1.数组 Array(Python list底层为动态数组)
在内存中开辟一块连续的内存空间。
核心特性
支持随机访问:通过下标直接定位元素,读取操作 $(O(1))$。
在数组尾部追加元素性能很高。
在数组中间/头部插入、删除元素性能差 $(O(n))$:插入一个元素,后面全部元素需要整体向后移位;删除,后面全部向前移位。
✅适合场景:高频读取、尾部增删; ❌不适合场景:大量在头部、中间位置插入删除。
arr = [10, 20, 30, 40]
print(arr[2])   # 通过下标直接访问 \(O(1)\)
arr.append(50)  # 尾部添加,速度快
arr.insert(0,5) # 头部插入,性能差,后面全部移位
动态数组:Python list,容量不够的时候,底层会重新申请一块更大连续内存,把旧数据复制过去。
2.链表 Linked‑List
链表内存不需要连续。 每一个节点由两部分组成:数据域 + 指针域。指针保存下一个节点的内存地址。
单向链表:节点只保存下一个节点地址,只能向后遍历;
双向链表:每个节点保存前驱、后继指针,可以向前、向后遍历。
核心特性
已知节点位置,插入、删除只修改指针,不需要移动大量数据,操作 $(O(1))$。
不能随机访问。想要取第k个元素,只能从头节点顺着指针逐个向后遍历,时间复杂度 $(O(n))$。
✅适合:频繁中间插入删除; ❌不适合:频繁按下标读取。
# 简单单向链表节点
class Node:
    def __init__(self, val):
        self.val = val
        self.next = None
数组 vs 链表对比
3.栈 Stack:后进先出 LIFO(Last‑In‑First‑Out)
类比:一摞盘子,后放上去的盘子,最先拿出来。 只允许在同一端(栈顶)做插入、取出。 操作:push入栈;pop出栈;peek查看栈顶元素。
典型应用场景
操作系统函数调用栈:函数A调用B,B调用C,执行完C回到B,再回到A,天然栈模型。
括号合法性校验,表达式解析。
浏览器后退功能。
Python list模拟栈:
stack = []
stack.append(1)   # push入栈
stack.append(2)
stack.pop()       # pop出栈,取出2
4.队列 Queue:先进先出 FIFO(First‑In‑First‑Out)
类比排队,先来先服务。 队尾入队,队头出队。
典型场景
服务器请求排队、消息队列、任务调度。
BFS广度优先搜索。
注意:普通list做队列,
pop(0)是头部删除,会移动全部元素,复杂度$(O(n))$,性能很差。 Python推荐双端队列collections.deque
from collections import deque
q = deque()
q.append(10)      # 队尾入队
q.append(20)
q.popleft()       # 队头取出,高性能 \(O(1)\)
5.哈希表 Hash Table(Python dict字典)⭐工程最高频
核心原理:哈希函数,输入key,经过哈希计算,直接得到数据存储位置。理想状态下,插入、删除、查询全部 $(O(1))$。
哈希冲突:不同key经过哈希函数计算得到同一个存储位置。需要冲突处理方案(链地址法等),冲突变多性能下降。
✅适用:高频查找、数据去重; ❌缺点:消耗更多内存;无序;key必须是可哈希类型(数字、字符串、元组),列表不能做key。
d = {"name":"zhangsan","age":22}
print(d["name"]) # 查询 \(O(1)\)
开发经验:遇到需要快速查找、去重,优先选择哈希表。
三、非线性数据结构:不再是一条直线
1.树 Tree
节点可以分出多个子节点,层级关系。 名词:
根节点:树最顶层节点;
叶子节点:没有子节点;
深度:节点距离根节点的层数。
二叉树:每个节点最多两个子节点(左孩子、右孩子)
二叉搜索树 BST
规则:左子树所有节点值 < 当前节点;右子树所有节点值 > 当前节点。 理想状态查找 $(O(logn))$。 ⚠️极端输入会退化成链表,查找退化 $(O(n))$。
平衡二叉树(AVL树、红黑树)
自动做平衡维护,防止退化成链表,保证查找维持 $(O(logn))$。
堆(优先队列)
特殊完全二叉树。分为大顶堆、小顶堆。 核心能力:快速获取最大值或者最小值。 业务场景:TOPK,从海量数据找出最大的N个数字。 Python标准库:heapq。
2.图 Graph
由顶点(节点)和边组成。 分类:无向图、有向图;带权重图。 场景:网络拓扑、导航路径、社交关系。 基础遍历算法:
DFS深度优先:一条路走到黑,回溯;
BFS广度优先:一层一层向外扩散。
初学者:掌握遍历概念即可,Dijkstra最短路径等复杂算法后期再学习。
四、经典基础算法
查找算法
1)顺序查找(暴力遍历)
从头到尾遍历,逐个比对目标。 复杂度:$(O(n))$。 优点:不需要数组有序; 缺点:大数据量慢。
2)二分查找(折半查找)⭐非常重要
硬性前提:数组必须有序! 思路:取中间元素,和目标对比; 如果目标更小,直接丢弃右半边;目标更大丢弃左半边;每次砍掉一半搜索范围。 时间复杂度 $(O(logn))$。
举例:100万有序数字,二分查找最多约20次即可找到目标;暴力遍历最坏要100万次。
Python示例:
def binary_search(arr, target):
    left = 0
    right = len(arr)-1
    while left <= right:
        mid = (left + right) // 2
        if arr[mid] == target:
            return mid
        elif arr[mid] < target:
            left = mid + 1
        else:
            right = mid - 1
    return -1 #没找到

a = [1,3,5,7,9,11,13]
print(binary_search(a,7))
排序算法
实际开发:几乎不会手写排序。直接调用语言内置排序函数。重点理解分治思想,不需要死记手写完整快排。
两大基础算法思想
分治:分而治之 把大问题拆成多个规模更小的子问题;子问题求解完成之后,合并结果。 例子:二分查找、快速排序、归并排序。
暴力枚举:遍历全部可能性,逻辑简单,大数据效率低。
进阶概念(初学了解即可,不用深挖):贪心、动态规划。
五、工程思维:怎么选择数据结构(最重要)
拿到业务需求,优先思考这几个问题:
我的数据是要多读,还是频繁插入删除?
是否需要快速查找某个元素?需要 → 优先哈希表dict。
是否要求有序?有序 → 可以考虑二分查找。
是否是排队、任务队列场景? → deque队列。
是否后进先出? → 栈。
不是背代码,而是根据业务场景选合适容器。
典型业务举例
日志解析,需要快速判断某个IP是否出现过 → 用集合set(哈希实现,去重查找(O(1)))
任务排队依次执行 → deque队列
判断括号字符串是否合法 → 栈
有序列表找元素 → 二分查找
六、和计算机底层知识串联
数组要求连续内存,依靠操作系统虚拟内存MMU完成地址映射;
函数调用栈,直接对应CPU、内存硬件层面的栈;
链表节点内存分散,容易产生内存碎片;
哈希表是典型的空间换时间,消耗更多内存换取查询速度。
✅必须掌握清单
大O时间复杂度,看得懂简单代码的复杂度等级。
数组、链表优缺点对比;栈LIFO、队列FIFO特性。
哈希表(字典)特性,适用场景。
二叉树基础概念;堆的用途。
二分查找:前提有序,$(O(logn))$,能看懂代码逻辑。
DFS、BFS概念;分治思想。
❌初学不需要深挖
红黑树完整源码实现、复杂图算法、高难度动态规划题目。
📌实操练习建议
手写二分查找;
使用栈实现括号匹配校验;
练习:列表去重,分别用循环对比 和 集合set实现,体会性能差距。
如果你需要,我可以给出:括号匹配完整可运行Python代码;
一套选择+简答练习题。
评论交流
欢迎留下你的想法