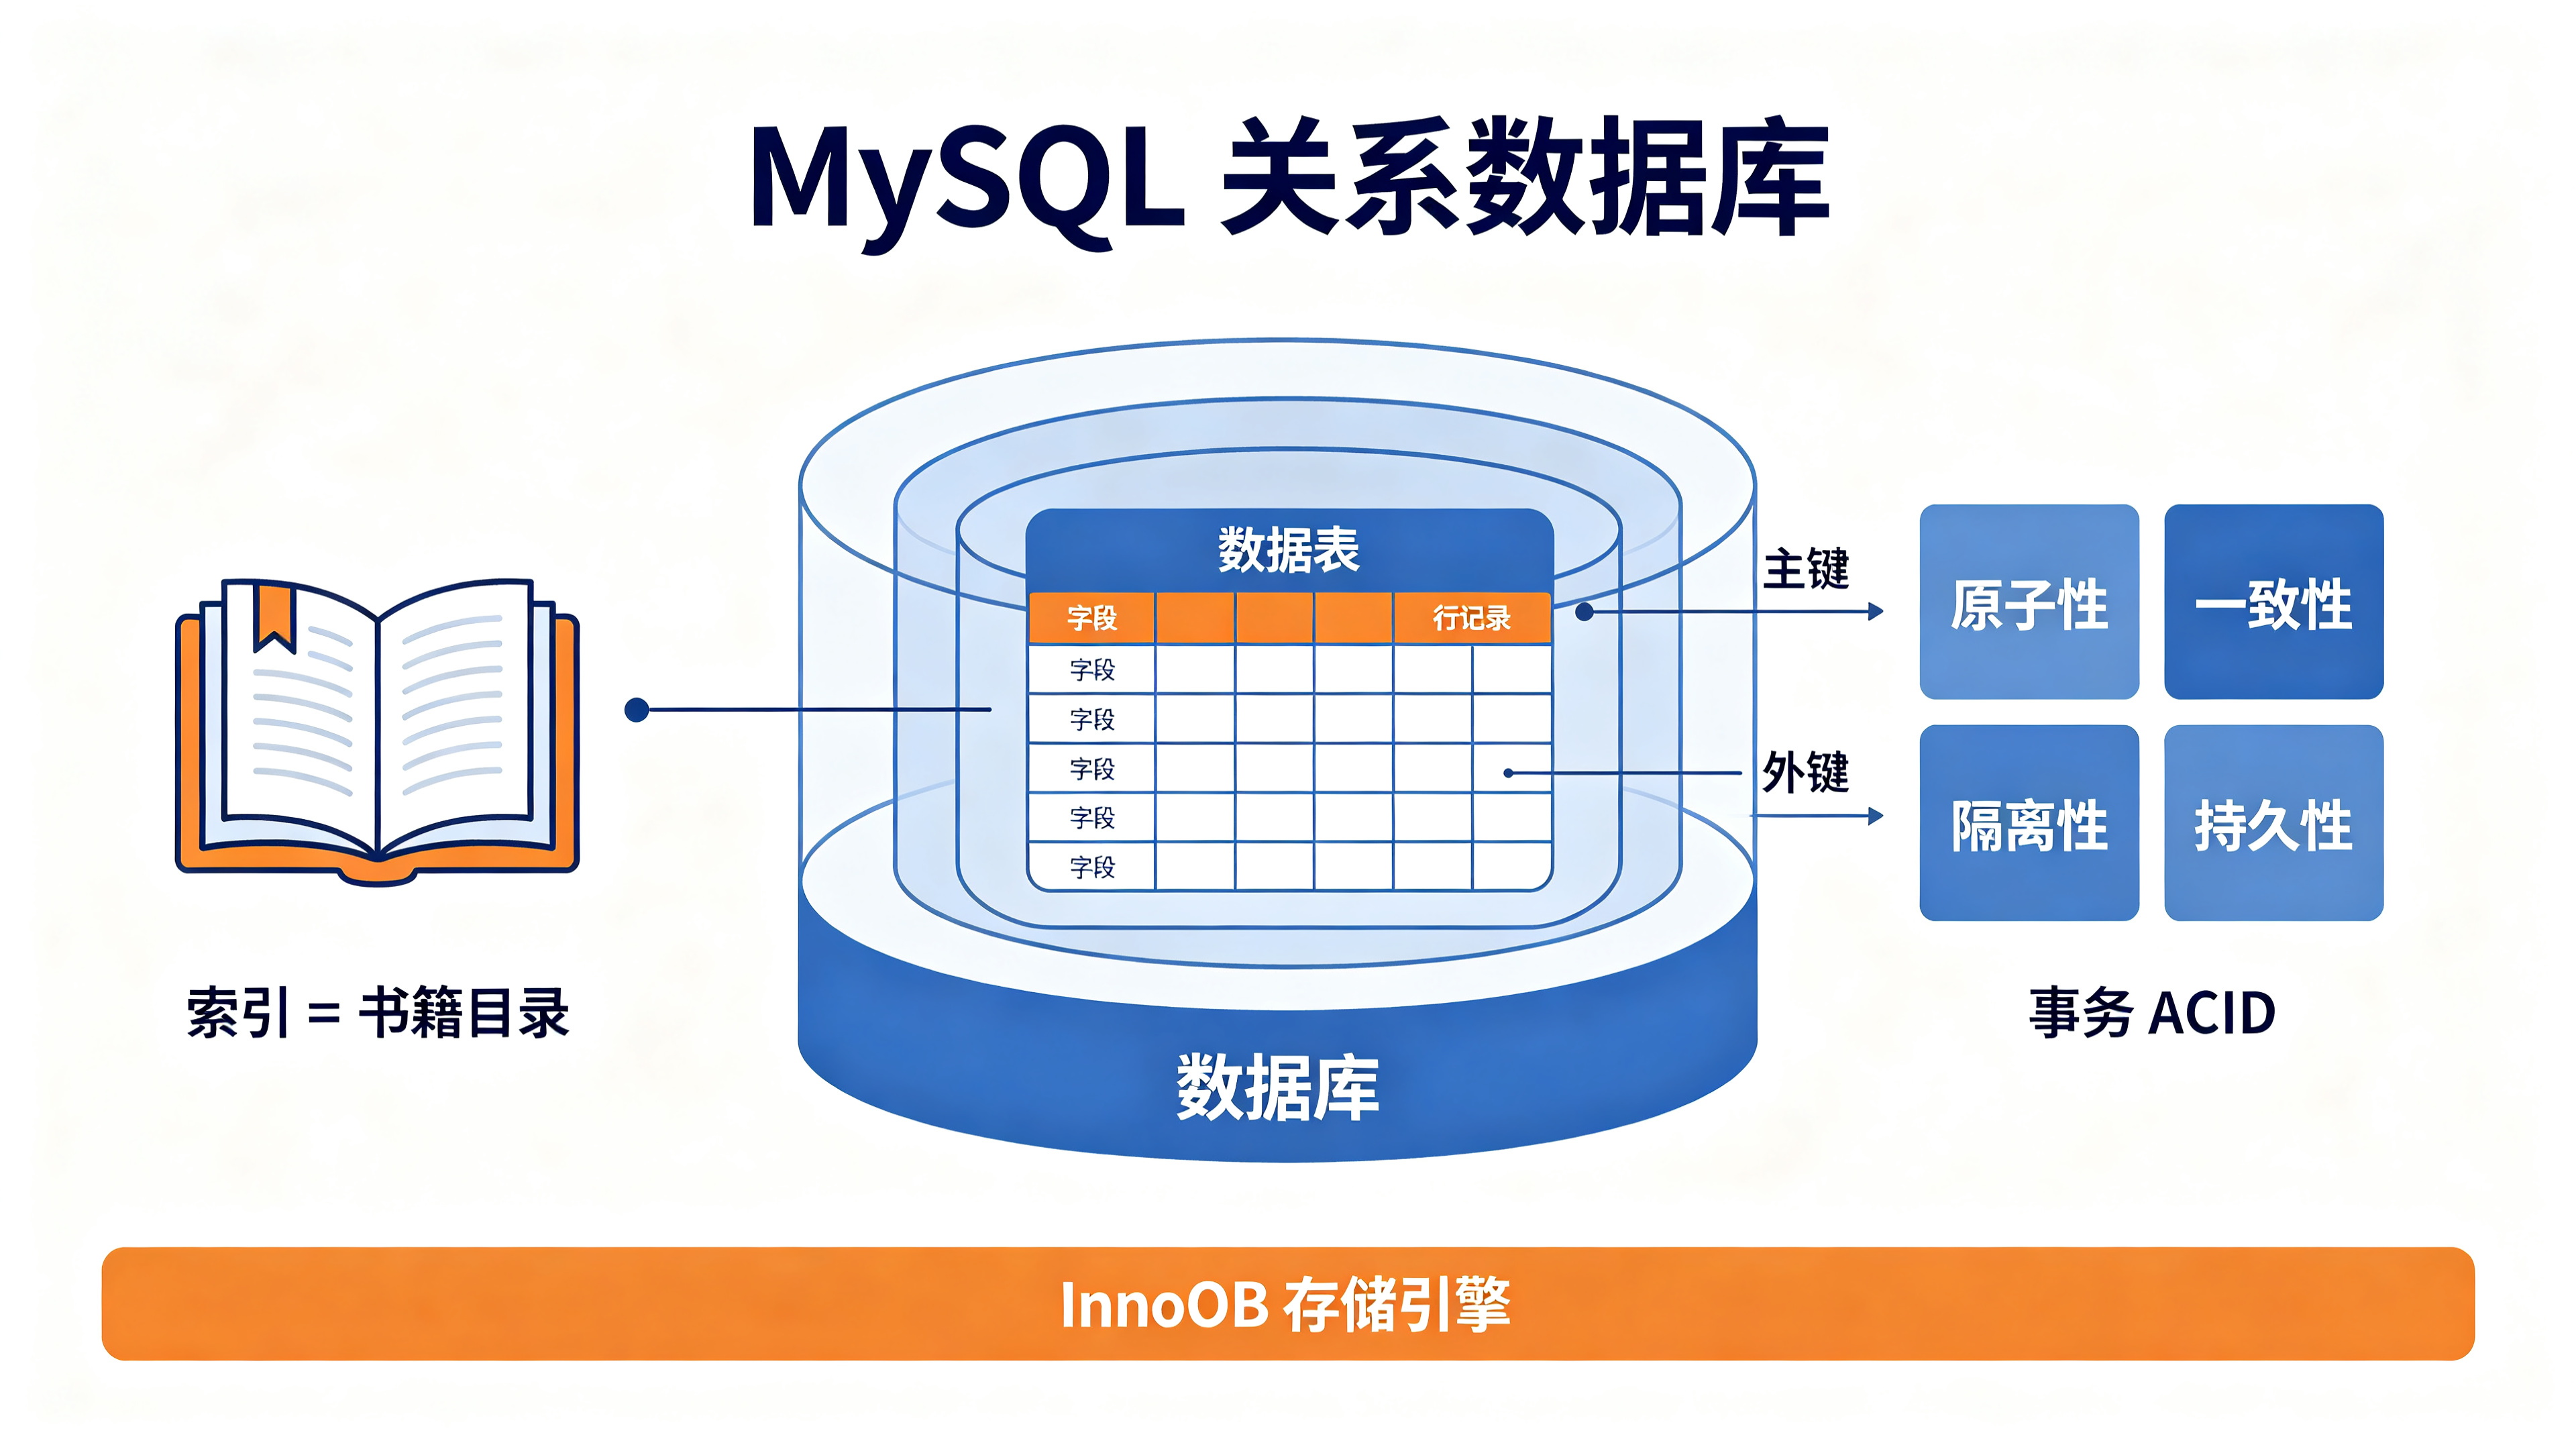
数据库:用来持久化存储、管理大量结构化数据的软件。数据保存在磁盘,程序重启数据不会丢失。 文件也可以存数据(txt、csv),但是文件做查询、筛选、修改、多程序同时读写非常麻烦。数据库专门解决这个问题。 MySQL属于关系型数据库,使用SQL语言操作。运维、后端开发、自动化脚本几乎都会接触。
学习目标:掌握库、表、字段、SQL增删改查、索引、事务,理解业务场景,会写常用SQL,看懂执行计划,不要求手写超高难度SQL。
一、基础概念
1.关系型数据库核心术语
数据库(database):一个独立业务的数据集合,一个MySQL实例可以有多个数据库。比如项目
user_db、order_db。表(table):一个数据库下面有多张表,一张表对应现实中一类事物。例如用户表
user、订单表order。行(row / 记录record):表中一行就是一条真实数据,一条用户信息就是一行。
列(column / 字段field):代表这条数据的属性,比如id、username、age、phone。
字段类型:规定这一列存什么数据(数字、字符串、时间)。
主键 primary key:唯一标识一行记录,整张表不能重复,不能为NULL。一般用id自增。
外键 foreign key:一张表引用另一张表的主键,用来做多表关联(运维场景很多时候不推荐大量外键,靠程序逻辑控制)。
关系型:表和表之间可以建立关联关系;数据以二维表格形式存储,行+列。
2.MySQL存储引擎
InnoDB(默认,必用) 支持事务、行级锁、外键,支持崩溃恢复。生产环境全部使用InnoDB。
MyISAM:老引擎,不支持事务,表锁,现在基本淘汰。
记住:生产环境一律用InnoDB。
3.SQL语言分类
SQL是操作数据库的统一语言,MySQL、PostgreSQL基本兼容。
DDL 数据定义语言:建库、建表、修改表结构
CREATE、ALTER、DROPDML 数据操作语言:增删改表里面的数据
INSERT新增、DELETE删除、UPDATE修改DQL 数据查询语言:查询数据,最常用 SELECT
DCL 数据控制语言:账号权限,
GRANT授权、REVOKE回收权限
二、DDL库、表操作
1.数据库操作
-- 创建数据库
CREATE DATABASE test_db DEFAULT CHARACTER SET utf8mb4;

-- 查看所有数据库
SHOW DATABASES;

-- 使用这个数据库
USE test_db;

-- 删除数据库
DROP DATABASE test_db;
✅字符集一定要用
utf8mb4,完整支持中文、emoji;不要用老的utf8(mysql的utf8不是完整utf‑8)。
2.建表
CREATE TABLE `user` (
  `id` INT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '主键id自增',
  `username` VARCHAR(50) NOT NULL COMMENT '用户名',
  `age` TINYINT DEFAULT NULL COMMENT '年龄',
  `phone` VARCHAR(11) DEFAULT NULL COMMENT '手机号',
  `create_time` DATETIME DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='用户表';
常用字段类型
整数
TINYINT:‑128~127;无符号0‑255,适合状态、年龄INT:普通整数,id常用
字符串
VARCHAR(n):可变长度字符串,节省空间,用户名、手机号用它CHAR(n):固定长度
时间
DATETIME:年月日时分秒,2026‑09‑05 12:30:00
TEXT:大文本,存长文本日志,不要滥用。
命名习惯:表名小写,下划线分割,不要用中文。
-- 查看表结构
DESC user;

-- 删除表
DROP TABLE user;
三、DML & DQL:增删改查(重中之重)
1.插入 INSERT
INSERT INTO user(username,age,phone)
VALUES ('zhangsan',20,'13800138000');
2.查询 SELECT(最常用)
基础语法
-- 查询全部列
SELECT * FROM user;

-- 查询指定字段
SELECT id,username,age FROM user;

-- where条件过滤
SELECT * FROM user WHERE age>18;

-- and 并且 ;or 或者
SELECT * FROM user WHERE age>18 AND username='zhangsan';

-- 模糊查询 %代表任意字符
SELECT * FROM user WHERE username LIKE 'zhang%';

-- order by 排序  ASC升序 DESC降序
SELECT * FROM user ORDER BY id DESC;

-- limit 分页,取前N条
SELECT * FROM user LIMIT 0,10; --从第0行开始取10条
WHERE条件运算符:> < >= <= = !=
⚠️不要随便写
SELECT *,生产尽量指定需要的字段,减少IO。
3.修改 UPDATE
-- 一定要带where条件!!不带where会更新整张表!重大事故!
UPDATE user SET age=22 WHERE id=1;
4.删除 DELETE
-- 根据条件删除,一定要写where
DELETE FROM user WHERE id=1;

--清空整张表(不推荐delete from user;)
TRUNCATE TABLE user; --清空表,重置自增id,速度快
⚠️高危:
update / delete不加where条件会操作全表,线上严禁直接执行,先select验证where条件是否正确。
聚合函数,统计
-- count统计行数,max最大,min最小,sum求和,avg平均值
SELECT COUNT(*) FROM user;
SELECT MAX(age),MIN(age),AVG(age) FROM user;

-- group by分组统计
SELECT age,COUNT(*) FROM user GROUP BY age;
多表查询(联表JOIN)
两张表关联查询,3种join:
INNER JOIN内连接:两边都匹配上的数据才返回LEFT JOIN左连接:左边表全部保留,右边匹配不到填nullRIGHT JOIN右连接
示例:用户表 user,订单表 orders,user.id = orders.user_id
SELECT u.username,o.order_no
FROM user u
LEFT JOIN orders o ON u.id = o.user_id;
初学重点搞懂left join,大部分业务场景使用left join。
子查询
select里面嵌套另一个select,简单看懂即可。
四、索引 Index⭐性能核心
没有索引:查询where条件会全表扫描,遍历表中每一行,数据量大极慢。 索引相当于书的目录,通过目录快速定位数据,不用逐页翻书。
索引存在磁盘上,会占用存储空间;提升查询速度,但是降低新增、修改、删除速度(修改数据同时要更新索引)。
索引分类 InnoDB
主键索引(聚簇索引) 主键自带索引,InnoDB数据本身就跟主键索引存放在一起。一张表只能一个主键。
2.普通索引
-- 创建普通索引
CREATE INDEX idx_user_name ON user(username);
3.唯一索引:索引列的值不能重复
CREATE UNIQUE INDEX idx_phone ON user(phone);
索引失效(高频踩坑)
写SQL要避免索引失效,导致全表扫描:
where条件索引字段做运算、函数运算,索引失效
where age+1>18不要这么写like '%关键词'左边百分号,索引失效;like '关键词%'可以走索引隐式类型转换,字符串字段传数字,索引失效
or条件一侧没有索引
查看SQL是否使用索引
EXPLAIN 在select前面加上,看执行计划
EXPLAIN SELECT * FROM user WHERE username='zhangsan';
看输出type列:
ALL:全表扫描,没有用到索引,需要优化;ref/range:正常用到索引。
索引经验:
where、join、order by经常用到的字段考虑建索引;
不要建过多索引,索引越多写入越慢;
字符串大字段不要建索引。
五、事务(InnoDB独有)
事务:一组SQL语句,要么全部成功,要么全部失败回滚,不会出现一半成功一半失败。 典型场景转账:A扣钱,B加钱;A扣成功,B不能因为程序崩溃不加钱。
事务四大特性 ACID
A原子性Atomicity:事务不可分割,全部成功或者全部回滚。
C一致性Consistency:事务前后数据整体状态合法。
I隔离性Isolation:多个事务并发操作,互相之间隔离。
D持久性Durability:事务提交成功,修改永久保存到磁盘,宕机不会丢失。
--手动事务
START TRANSACTION; --开启事务
UPDATE account SET money=money‑100 WHERE id=1;
UPDATE account SET money=money+100 WHERE id=2;
COMMIT; --提交,真正写入磁盘
-- ROLLBACK; 回滚,撤销全部操作
如果中间报错,执行rollback回滚,所有修改作废。
事务隔离级别(了解)
读未提交、读已提交、可重复读(MySQL InnoDB默认)、串行化。 会产生问题:脏读、不可重复读、幻读。初学记住默认REPEATABLE‑READ即可。
锁机制(InnoDB)
行锁:操作某一行,锁住这一行,其他行不受影响。事务+索引生效。
表锁:锁住整张表,并发性能差。MyISAM是表锁。
重点:如果where条件没有命中索引,InnoDB行锁会退化成表锁!并发直接卡死。
六、MySQL账号与权限 DCL
-- 创建用户,允许从指定ip登录
CREATE USER 'test'@'127.0.0.1' IDENTIFIED '123456';

--授予权限
GRANT SELECT,INSERT,UPDATE,DELETE ON test_db.* TO 'test'@'127.0.0.1';

--刷新权限
FLUSH PRIVILEGES;

--回收权限
REVOKE ...
安全最佳实践:不要使用root账号对外访问;账号限制登录IP,密码复杂度。
七、常用运维与问题
备份mysqldump
#备份整个数据库
mysqldump -u root -p test_db > test_db.sql

#恢复
mysql -u root -p test_db < test_db.sql
2.慢查询日志:记录执行很慢的SQL,用来定位慢SQL优化。 3.生产禁止:select *、不加where的update/delete、大事务一次性更新几十万行。
八、范式(数据库设计)
范式是表设计规范,减少数据冗余。
第一范式:字段不可再拆分。
第二范式:非主键字段完全依赖主键。
第三范式:非主键字段不能依赖其他非主键字段。
实际开发:适度反范式,允许少量冗余,减少多表join,提升查询速度。不要死板严格遵守三范式。
✅必须掌握清单
库、表、行、列、主键概念;InnoDB引擎特点。
CRUD增删改查,where条件、limit、order by、group by。
LEFT JOIN联表查询。
索引作用,会简单建索引,知道索引失效常见场景,会用explain看执行计划。
事务ACID,commit提交、rollback回滚。
mysqldump备份基础命令。
高危操作:update/delete不加where的巨大风险。
❌初学暂时不用深挖
MVCC底层原理、锁全部细节、复杂存储过程、触发器。
📌实操练习建议
1.本地搭建MySQL,Navicat/DBeaver连接; 2.建一张用户表、一张订单表,练习insert、select、update、delete; 3.练习left join两表关联; 4.练习建索引,使用explain观察索引是否生效; 5.手动写事务,模拟失败rollback回滚。
如果你需要,我可以提供: 1.可直接复制的练习建表+测试数据SQL脚本; 2.一套SQL练习题。
评论交流
欢迎留下你的想法